MiniMax H3 prova il video su una griglia di pixel
Due adapter della community portano H3 verso la pixel animation. La distinzione utile è fra un'immagine che sembra pixel art e una sequenza che mantiene davvero griglia, palette e cadenza.
Due LoRA per H3: il pixel non è soltanto uno stile
Il 3 ottobre sono comparsi su Hugging Face due adapter indipendenti per MiniMax H3: pixelart8x di JOYUNGI e PixelTune di ij. Non sono nuovi modelli ufficiali MiniMax, ma pesi aggiuntivi che orientano il modello verso la pixel animation. Entrambi cercano qualcosa di più preciso del consueto look rétro: celle riconoscibili, colori limitati e movimento da sprite. È una novità interessante per motion designer e animatori perché sposta il problema dalla descrizione dello stile alla struttura dei fotogrammi. I due progetti, però, restano sperimentali: non vanno letti come una pipeline già pronta per la consegna. ([fervorcreativeai.com])
pixelart8x lavora su una griglia con celle da otto pixel. La scheda indica un prefisso da inserire nel prompt, dimensioni multiple di 32 pixel e una richiesta esplicita di assenza del suono negli esempi. Il training combina 20 immagini e 60 clip. Il limite dichiarato è importante anche sul piano creativo: le immagini del dataset mostrano soprattutto personaggi anime a figura intera, con abiti militari e fondali piatti. Quella distribuzione può condizionare l'aspetto del risultato. Non basta quindi cambiare soggetto nel prompt per considerare l'adapter neutro rispetto al design. ([huggingface.co])
PixelTune separa più nettamente generazione e finitura. Nel prompt si dichiara un canvas nativo; il modello genera a quattro volte quelle dimensioni. La scheda descrive poi un postprocessor distinto che corregge la griglia, applica una palette condivisa alla clip e ingrandisce con nearest-neighbor. È il passaggio decisivo: i confini esatti dei pixel mostrati dall'app non dipendono soltanto dai pesi della LoRA. I campioni grezzi pubblicati sono invece senza quelle correzioni. Anche il checkpoint è preliminare: 1.000 step di training, non il ciclo completo previsto, e nessuna approvazione finale dichiarata sulla qualità estetica o sul movimento. ([huggingface.co])
Resta da verificare soprattutto la stabilità temporale. PixelTune segnala possibili incoerenze nei dettagli, nelle zone statiche e nei bordi delle celle; avverte inoltre che un valore migliore della loss non dimostra un risultato visivamente migliore. La compatibilità del caricamento automatico in ComfyUI non è stata verificata. Per una valutazione di produzione, proponiamo quindi un test piccolo: camera ferma, un solo gesto, fondale semplice e confronto fra output grezzo e output trattato. Entrambi gli adapter sono derivati di H3 e mantengono la sua Community License, comprese le restrizioni territoriali e d'uso: scaricare i pesi non amplia i diritti sul modello. ([huggingface.co])
- Pubblicazione
- 3 ottobre, su Hugging Face
- Griglia pixelart8x
- Celle da 8 pixel; dimensioni multiple di 32 pixel
- Training pixelart8x
- 20 immagini e 60 clip
- Checkpoint PixelTune
- Preliminare, 1.000 step di training
- Licenza
- Community License di H3, comprese restrizioni territoriali e d'uso
- pixelart8x — real pixel-art LoRA for MiniMax H3 JOYUNGI / Hugging Face
- PixelTune · MiniMax H3 pixel-art LoRA ij / Hugging Face
- Creative AI Briefing: October 4, 2026 (Morning) Fervor Creative AI
In breve tutte le notizie →
557 adapter vocali, con un'avvertenza sulla controllabilità
LAION ha pubblicato il 3 ottobre una raccolta di 557 LoRA rank-1 per Humaneness Voice Small: 500 profili vocali, 40 gruppi emotivi e 17 gruppi di attributi. Sono adapter separati, non un mixer di controlli garantiti. Il repository include loader, esempio d'inferenza CUDA e statistiche di training. La scheda distingue chiaramente fra training completato e capacità dimostrata di controllare una voce o un'emozione; sconsiglia inoltre di sovrapporre adapter senza valutare la combinazione. La licenza indicata è CC BY 4.0. ([fervorcreativeai.com])
Wan 2.2 diventa un bundle per generare sul dispositivo Apple
Il 4 ottobre Aether Engine Models ha pubblicato una conversione INT8 di FastWan2.2-TI2V-5B per il proprio SDK, destinata a iOS e macOS 27 o successivi. Parte da un'immagine e un prompt e produce al massimo 49 frame, circa due secondi a 24 fps, con tre step d'inferenza. È un bundle per sviluppatori, non un'app pronta. Il download pesa 13,02 GB; la scheda riporta circa 37,75 GB occupati dopo la preparazione iniziale sul dispositivo testato. Su iOS serve anche uno specifico entitlement per la memoria. ([fervorcreativeai.com])
Cambiare il costume senza ridisegnare tutto il personaggio
Il 4 ottobre ausboss ha pubblicato una LoRA per l'outfit swap con Qwen Image 2.1. Si forniscono due immagini, persona e abito, chiedendo di mantenere viso, capelli, mani, posa e fondale. Nei 16 test dichiarati dall'autore, lo spostamento mediano rispetto all'originale scende da 3,6 a 0,1 pixel; sono misure interne, non una validazione indipendente. È incluso un workflow ComfyUI. Restano problemi con scarpe e oggetti sovrapposti ai vestiti, mentre la posa viene conservata anche quando il nuovo costume richiederebbe di modificarla. La scheda indica la Qwen Research License. ([fervorcreativeai.com])
Un faro, pochi colori, un solo movimento
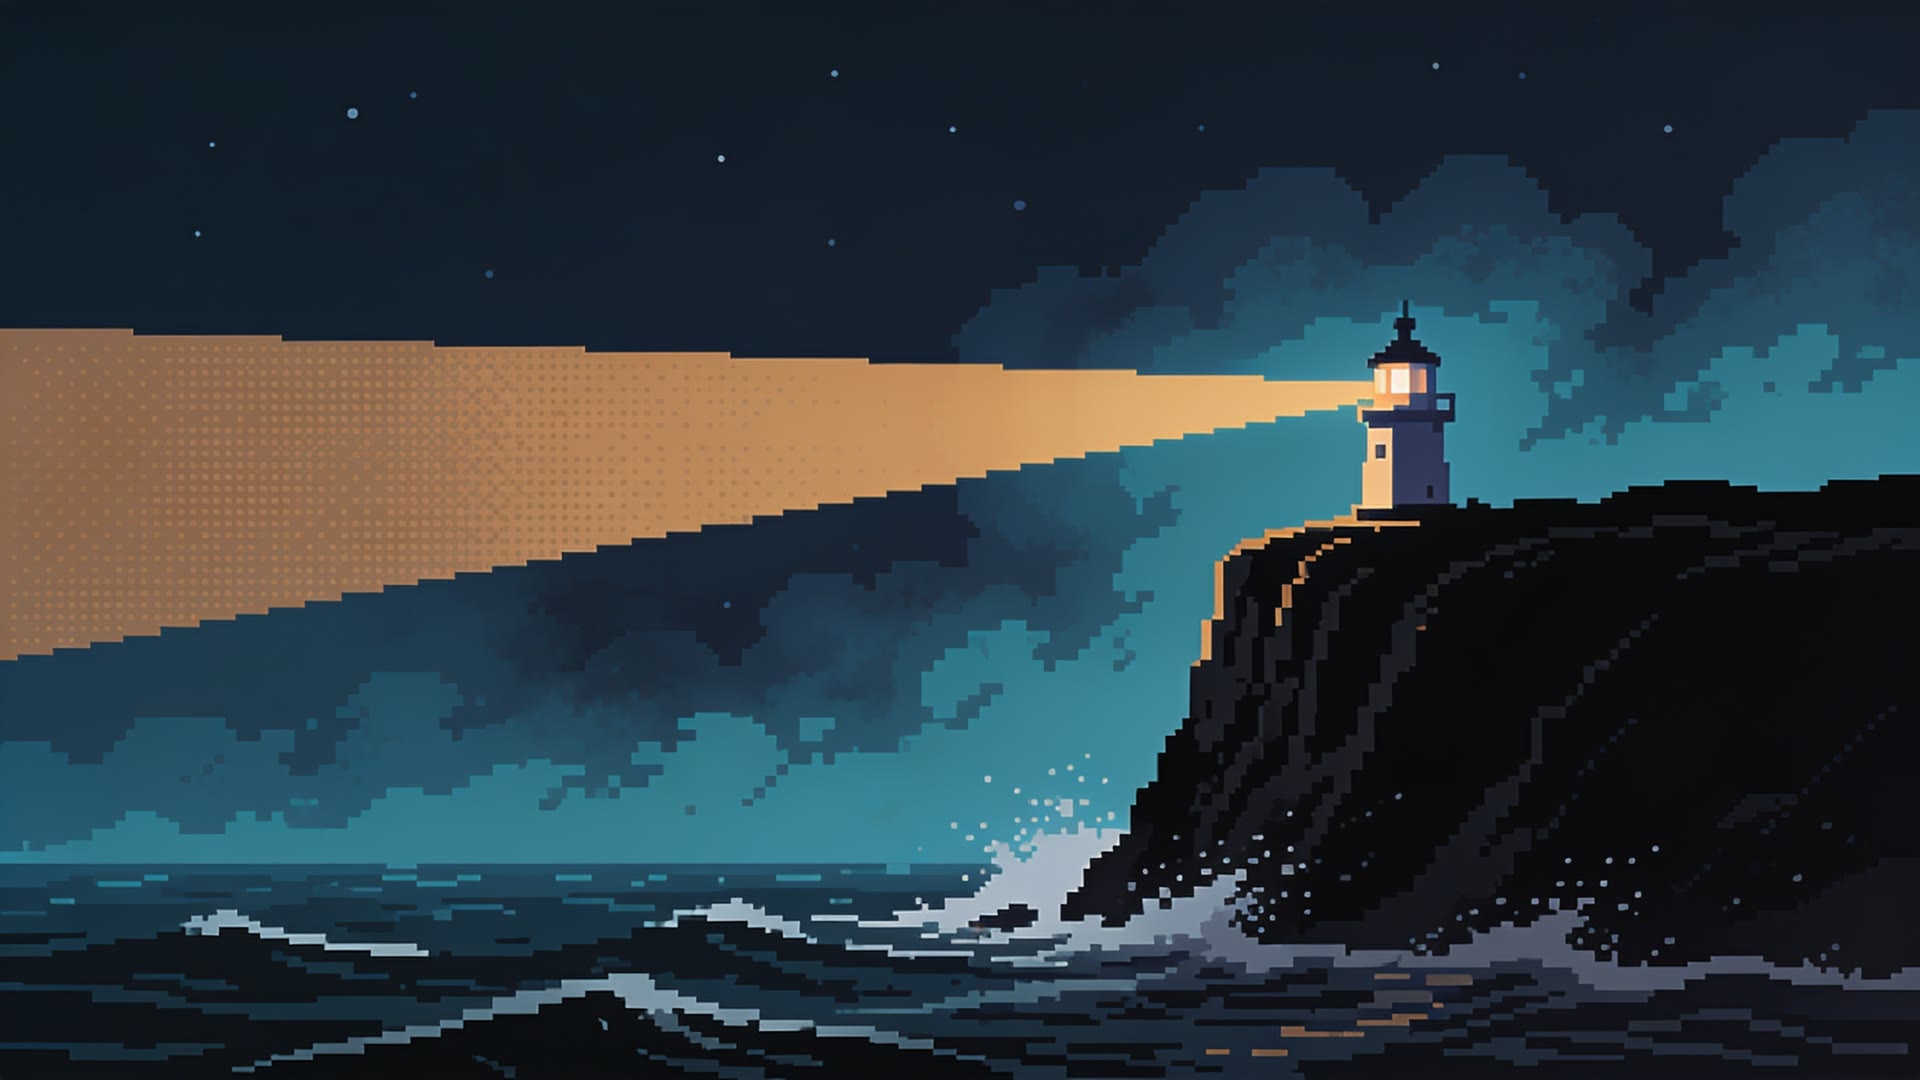
Proviamo una scena cinematografica costruita come un fondale da pixel animation, con silhouette leggibili e luce netta. Nell'animazione chiediamo un solo evento: il passaggio del fascio del faro, lasciando ferma la camera.
Horizontal 16:9 cinematic pixel-art scene of a solitary lighthouse on a black volcanic cliff above a stormy sea at night. Wide composition inspired by a 35mm lens, lighthouse on the right third, vast negative space to the left. A sharp amber beam cuts through cobalt mist. Limited navy, cyan, amber and charcoal palette, crisp square pixels, stepped silhouettes, dramatic rim light, carefully separated depth layers. No lettering, logos or photorealistic textures.
Locked-off wide shot. The lighthouse beam slowly sweeps across the mist while the tower and cliff remain perfectly still. Preserve the square pixel shapes and limited palette. No camera movement, no zoom, no new objects, no sound.
Modello consigliato: Nano Banana. Tieni il fondale originale come riferimento e confronta alcuni frame distanti fra loro: bordi che tremano e colori che cambiano si leggono meglio fuori dal playback continuo.
Una domanda pratica — un workflow, quale modello conviene, come verificare un risultato — e la risposta arriva da tutte le edizioni, dai Weekly e dal Manuale, con le fonti e quello che c'è già in FAC. Le risposte sono per il team di Frameworks.
- Come impostiamo un confronto tra output grezzo e postprocessato dei due adapter pixel per H3?
- Quali verifiche servono prima di combinare gli adapter vocali LAION?
- Quali requisiti di sistema e memoria richiede il bundle locale FastWan2.2?
- Come controlliamo separatamente costume, volto e fondale negli edit con gemini o seedream?
Hai trovato qualcosa che dovremmo leggere?
Un tool, un workflow, un modello, una norma, un artista: mandaci il link e due righe sul perché conta. La redazione legge tutto e il meglio finisce nel notiziario.
📋 Sommario in testo con i link da incollare in chat