Odyssey-3 apre i mondi generati all’interazione
Odyssey-3 si può esplorare in una preview pubblica: il mondo risponde alle azioni, non soltanto al prompt iniziale. Per la regia è una direzione da osservare, non ancora un workflow di produzione da adottare.
Odyssey-3: entrare nella scena, invece di aspettare una clip
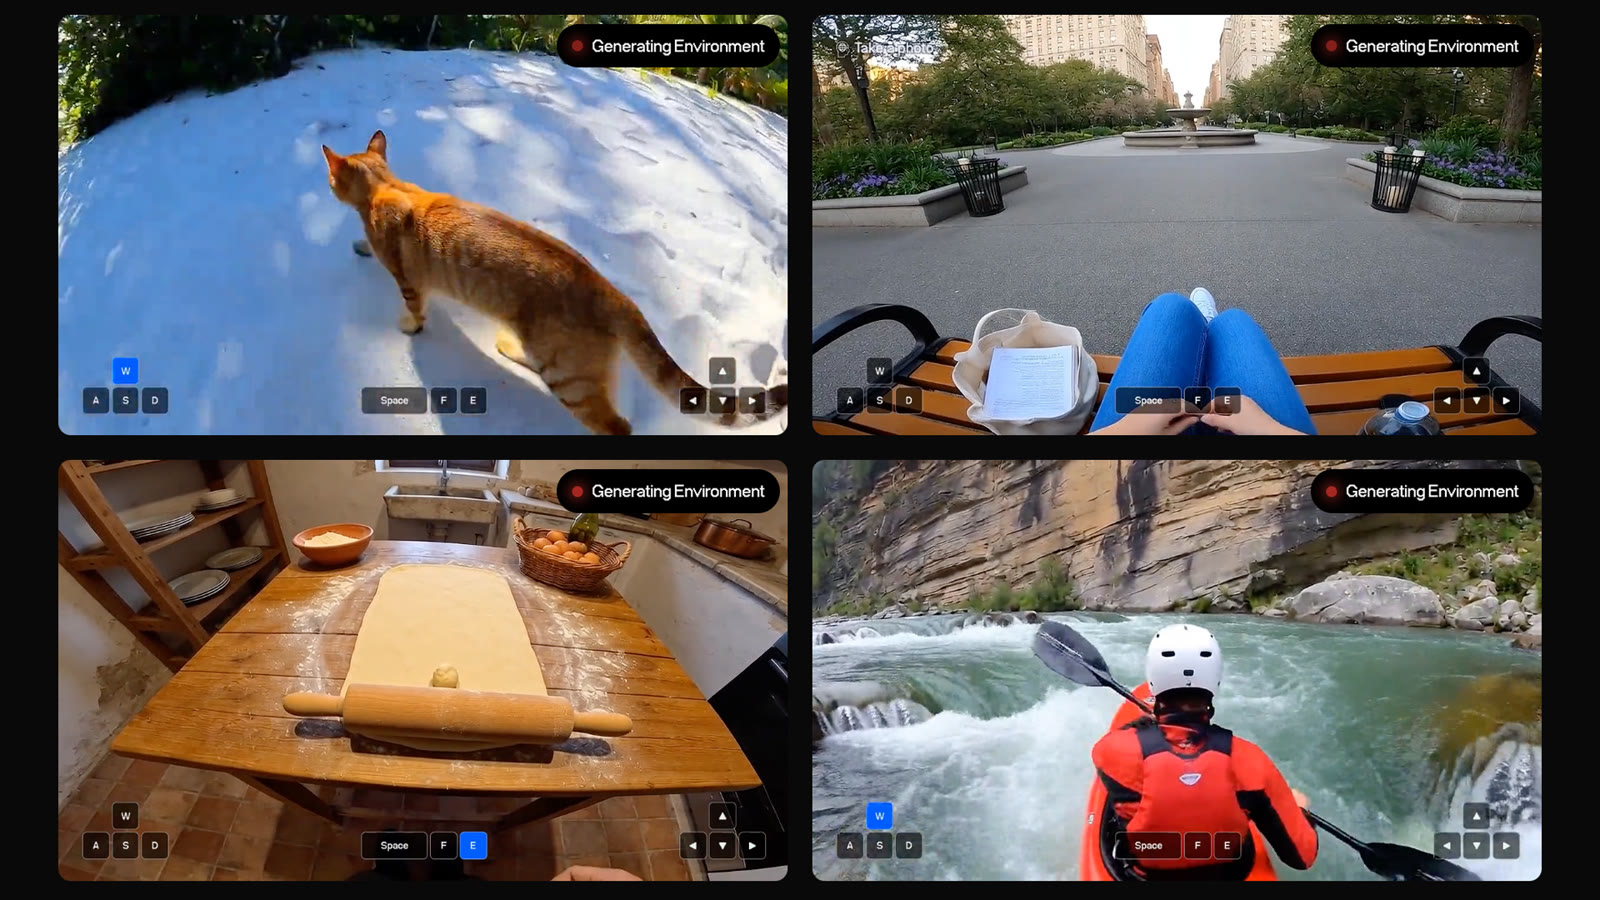
The Decoder segnala l’11 ottobre la disponibilità pubblica di Odyssey-3, un world model da 14 miliardi di parametri che genera ambienti interattivi da descrizioni testuali. La novità non è la prima presentazione del modello, avvenuta il 15 settembre, ma l’accesso alla research preview, accompagnato da dettagli tecnici e risultati di valutazione. La demo gratuita usa Odyssey-3 Flash: permette di scegliere una prospettiva in prima o terza persona, muoversi nell’ambiente e provocare eventi. È questo il punto da osservare: l’immagine continua a cambiare mentre chi guarda interviene. ([the-decoder.com])
Il sistema genera nuovi fotogrammi a partire dai precedenti e dalle azioni dell’utente, attraverso un autoregressive diffusion transformer. Secondo Odyssey, l’addestramento gli permette di apprendere relazioni fisiche e di causa-effetto dalle osservazioni visive. Per un regista, proponiamo di leggere questa impostazione come una possibile pista per esplorare lo spazio: non chiedere subito un’inquadratura definitiva, ma verificare cosa succede attraversando una soglia, avvicinandosi a un oggetto o cambiando direzione. È una proposta di test creativo, non una capacità di previs professionale già dimostrata. Il criterio dovrebbe essere la leggibilità dell’azione, prima della bellezza del singolo frame. ([the-decoder.com])
Le dichiarazioni sulla fisica richiedono cautela. The Decoder rileva che il risultato presentato come record su Physics-IQ Verified deriva da una selezione fra più generazioni e non soddisfa tutti i requisiti previsti per rivendicare un primato. Sono disponibili anche risultati su più esecuzioni, ma le valutazioni sono state inviate dall’azienda stessa. Non leggiamo quindi il benchmark come una garanzia di continuità per uno shot: proponiamo invece di cercare errori nei contatti, nelle occlusioni e nel rapporto fra gesto e conseguenza. Un ambiente convincente a colpo d’occhio dovrebbe essere messo alla prova con azioni semplici e ripetibili. ([the-decoder.com])
Per il nostro lavoro, la domanda utile resta aperta: quanto controllo potremmo conservare passando dall’esplorazione a una sequenza approvabile? Prima di inserirlo in una pipeline, chiediamo prove su ripetibilità, conservazione dei dettagli, gestione delle reference e possibilità di riprendere una scena dopo una correzione. Nella demo proveremmo un percorso breve: entrare in una stanza, aggirare un elemento centrale, tornare verso l’ingresso. Annoteremmo dove cambiano proporzioni, materiali o posizione degli oggetti, senza confondere una buona sorpresa con una scelta riproducibile. Il test aiuterebbe a distinguere due obiettivi diversi: trovare un’idea di regia oppure eseguire un’inquadratura già decisa. Per ora trattiamo Odyssey-3 come ricerca da esplorare, senza attribuirgli strumenti di consegna non verificati.
- Parametri
- 14 miliardi
- Prima presentazione
- 15 settembre
- Disponibilità
- Research preview pubblica segnalata l’11 ottobre
- Demo
- Gratuita, con Odyssey-3 Flash
- Prospettive
- Prima o terza persona
In breve tutte le notizie →
SeeThrough mostra il segnale AI, ma chiarisce cosa non dimostra
SeeThrough ha rilasciato il 10 ottobre la versione 0.12.0. Il detector aggiunge spiegazioni sotto il risultato e una heatmap Grad-CAM, che aiuta a leggere quali parti del frame influenzano il punteggio. Il changelog definisce queste visualizzazioni supporti sperimentali alla review, non mappe dei pixel generati. Chiarisce inoltre che buoni benchmark non garantiscono prestazioni su nuovi filmati e che il rilevamento di face-swap e lip-sync deepfake non è validato. È un aggiornamento utile soprattutto per rendere meno ambiguo il responso del detector, non una certificazione dell’origine del video. ([see-through.ca])
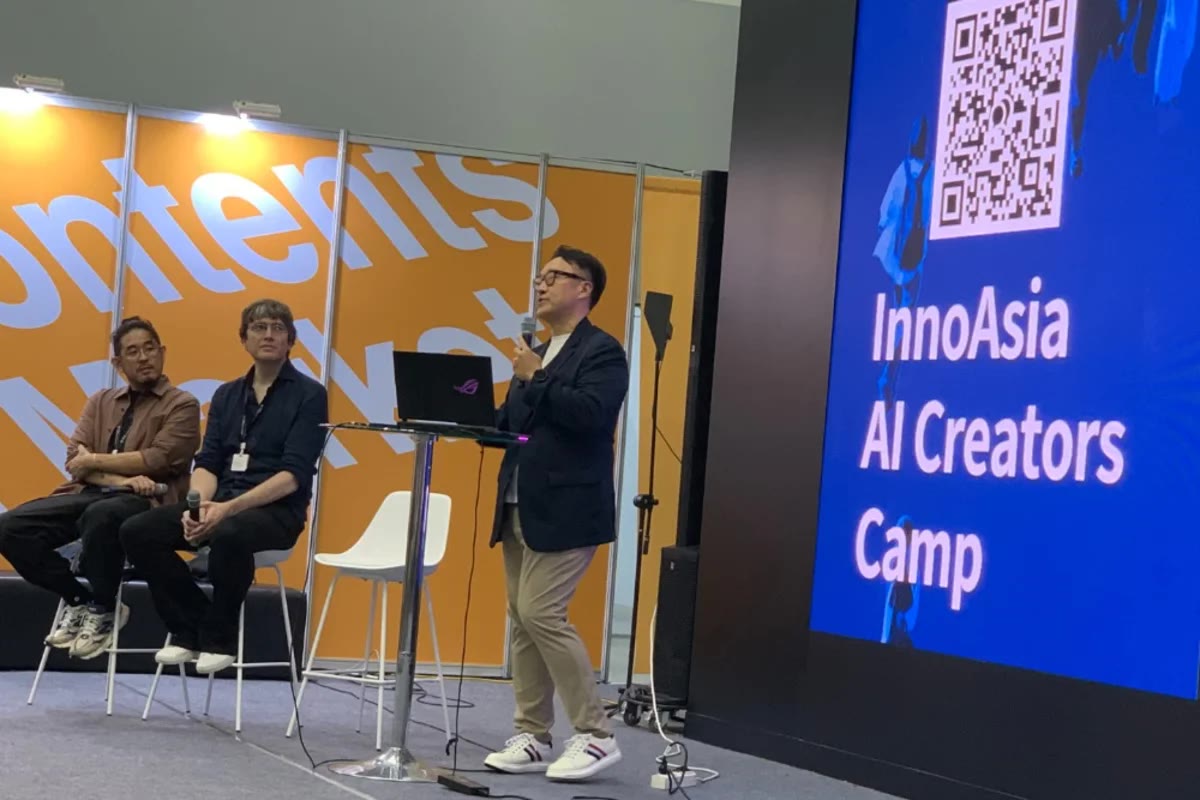
A Busan, il discorso passa dall’immagine alla pipeline
All’InnoAsia AI Creators Camp di Busan, l’11 ottobre, il producer-director di Viscode Hong Jae Cheol ha descritto il passaggio dalla generazione di immagini isolate a workflow completi. Nel resoconto di Variety, gli impieghi citati comprendono rotoscoping, cleanup, previs, character design, camera test e creazione di ambienti. Hong sostiene che piccoli studi AI-native possano sviluppare progetti originali, mentre gli studi tradizionali conservano vantaggi in infrastruttura, talenti e distribuzione. È una lettura dell’organizzazione produttiva, non l’annuncio di un nuovo modello né una dimostrazione di risparmi applicabili a ogni progetto. ([malaysia.news.yahoo.com])
Una stanza da attraversare, non soltanto da guardare
Costruiamo una scena con una soglia, un elemento centrale e un fondo riconoscibile. L’animazione servirà a verificare la geometria attraverso un’occlusione: una piccola prova di continuità spaziale, ispirata ai mondi interattivi di Odyssey-3.
Cinematic horizontal 16:9 image of an abandoned tidal observatory, viewed through a narrow concrete doorway. A suspended brass sphere hangs above a shallow pool at the center, with three massive pillars separating foreground, midground, and background. Cold dawn light enters through a distant circular opening, reflecting across wet stone. Shot on a 28mm lens, low camera height, strong depth, restrained teal, charcoal, and muted gold palette. Photoreal materials, atmospheric haze, no lettering, no logos.
Slow lateral camera dolly past the doorway, letting the nearest pillar briefly occlude the brass sphere before revealing it again. The sphere sways gently and small ripples cross the pool. Preserve the room geometry, lighting, and object positions throughout.
Modello consigliato: Seedream. Usa il pilastro come controllo: confronta la sfera e il fondo prima e dopo l’occlusione. Se cambiano posizione o proporzioni, correggi il test prima di aggiungere altri movimenti.
Una domanda pratica — un workflow, quale modello conviene, come verificare un risultato — e la risposta arriva da tutte le edizioni, dai Weekly e dal Manuale, con le fonti e quello che c'è già in FAC. Le risposte sono per il team di Frameworks.
- Quale percorso possiamo provare in Odyssey-3 per verificare occlusioni e coerenza degli oggetti?
- Quali limiti dichiara SeeThrough per heatmap, face-swap e lip-sync?
- Quali verifiche servono prima di inserire Odyssey-3 in una pipeline?
- Come possiamo progettare il passaggio da reference a shot e post usando FAC?
Hai trovato qualcosa che dovremmo leggere?
Un tool, un workflow, un modello, una norma, un artista: mandaci il link e due righe sul perché conta. La redazione legge tutto e il meglio finisce nel notiziario.
📋 Sommario in testo con i link da incollare in chat