La voce risponde in tempo reale, la regia resta nelle reference
ElevenLabs presenta due modelli speech-to-speech per conversazioni dal vivo. Per personaggi interattivi e prototipi narrativi, il test utile riguarda pause, interruzioni e tenuta della voce, non soltanto la velocità.
Eleven Realtime porta il personaggio dentro la conversazione
ElevenLabs ha presentato Eleven Realtime v1 Mini e v1 Max, due modelli speech-to-speech per conversazioni in tempo reale. Il lancio del 20 ottobre comprende l’accesso attraverso ElevenAgents e una API pubblica: non soltanto voci da generare, dunque, ma interlocutori che ascoltano e rispondono durante uno scambio.
La distinzione proposta dall’azienda riguarda il compito. Mini è destinato alle conversazioni naturali e comprende fra gli impieghi dichiarati i personaggi interattivi; Max punta alle richieste complesse e ai processi articolati. Per un prototipo narrativo, partirei quindi da Mini, passando a Max soltanto quando il personaggio deve anche eseguire operazioni.
Il dato più evidente riguarda Max: secondo i risultati riportati, raggiunge il 98,8% su Big Bench Audio e comincia a parlare mediamente dopo 0,57 secondi. Sono misure di ragionamento vocale e tempo al primo audio nel benchmark. Non le leggerei come una valutazione della recitazione o della qualità di una scena dialogata.
L’accesso tecnico merita attenzione prima di promettere una demo. La API usa WebSocket e segue le specifiche della Realtime API di OpenAI; ElevenLabs indica che un’integrazione WebRTC deve prima cambiare trasporto. Inoltre, la API Realtime è separata da ElevenAgents: le funzioni della piattaforma non arrivano automaticamente insieme al collegamento audio.
La prova creativa che proporrei è piccola: un personaggio originale, un ambiente sonoro semplice e una conversazione con pause intenzionali. Interrompiamolo mentre risponde, cambiamo intenzione a metà frase e riprendiamo dopo un silenzio. L’obiettivo del test sarebbe capire se lo scambio conserva ritmo e credibilità, non produrre subito una performance definitiva.
Terrei separati anche i criteri di ascolto. Una risposta rapida non basta per approvare una voce: nel nostro test annoterei pronuncia, intenzione, gestione dell’interruzione e coerenza del personaggio. Registrerei gli scambi da riascoltare senza interazione, così da distinguere l’effetto della conversazione dal valore effettivo della performance ottenuta.
Restano da verificare sul nostro caso l’italiano, la direzione espressiva e la ripetibilità dello scambio. Non abbiamo ancora un test interno su questi aspetti. Prima di proporlo per un’installazione o un’esperienza narrativa, preparerei quindi un confronto ascoltabile fra Mini e Max, con gli stessi obiettivi di scena e condizioni dichiarate.
- Modelli
- Eleven Realtime v1 Mini e v1 Max
- Big Bench Audio
- Max: 98,8%
- Primo audio
- Max: 0,57 s medi nel benchmark
- Disponibilità
- ElevenAgents e API WebSocket
In breve tutte le notizie →
Lightroom mobile riapre gli occhi e allarga il frame
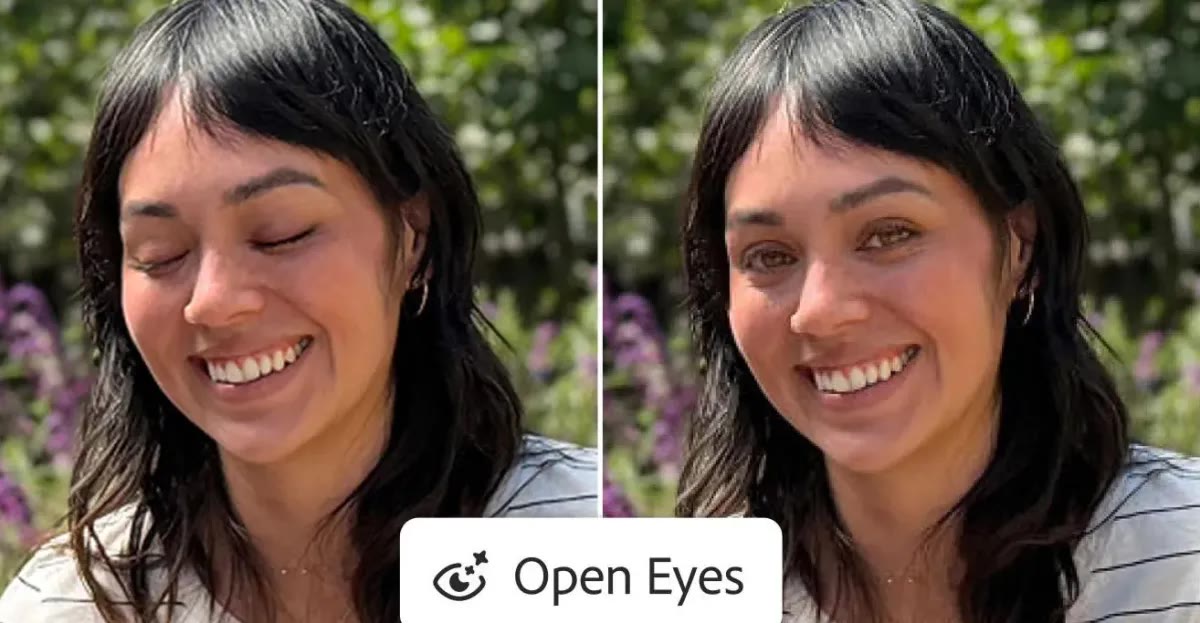
Adobe ha annunciato Open Eyes e Generative Expand per Lightroom mobile. La prima funzione propone una Quick Action quando rileva occhi chiusi; la seconda estende la scena oltre i bordi originali per cambiare inquadratura e formato.
Voxtral 3 separa ascolto, ragionamento e voce
Mistral ha lanciato Voxtral 3, una famiglia di modelli di trascrizione e sintesi vocale accompagnata da un SDK per agenti vocali. La pipeline collega ascolto, ragionamento, uso di strumenti e risposta parlata in uno scambio in tempo reale.
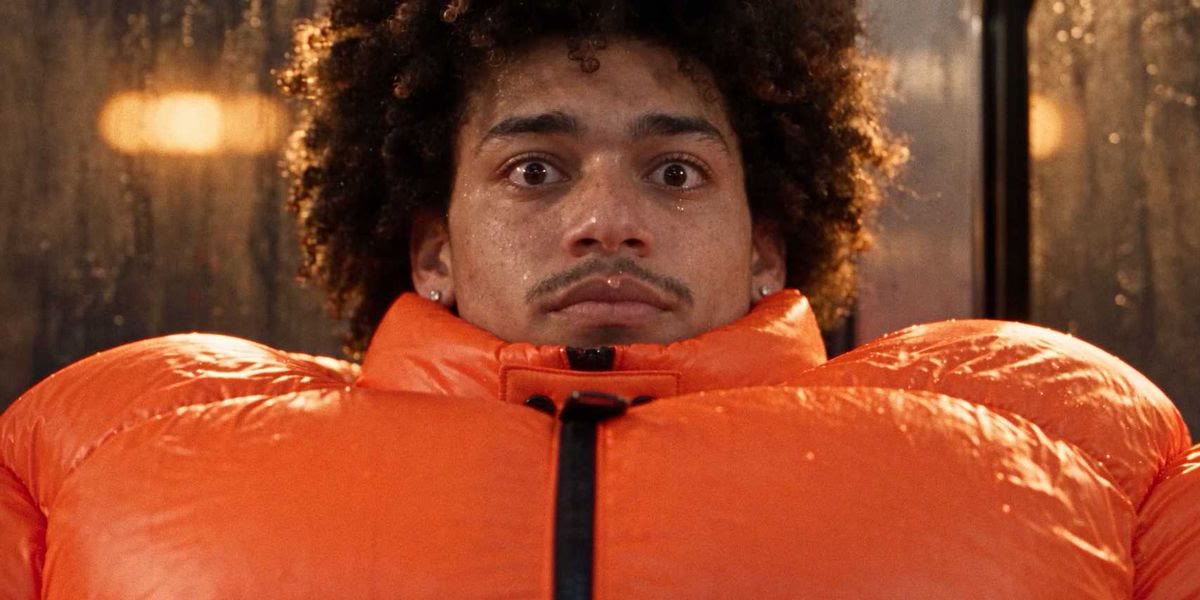
Uno spot accantonato torna con casting e blocking prima del video
Cassandra Brooksbank racconta di aver ripreso con l’AI un progetto AXE accantonato nel 2021 per ragioni di budget. Il risultato è For Days That Run Hot, uno spec non ufficiale di 60 secondi, non una campagna commissionata dal marchio.
Il costume racconta prima dell’attore
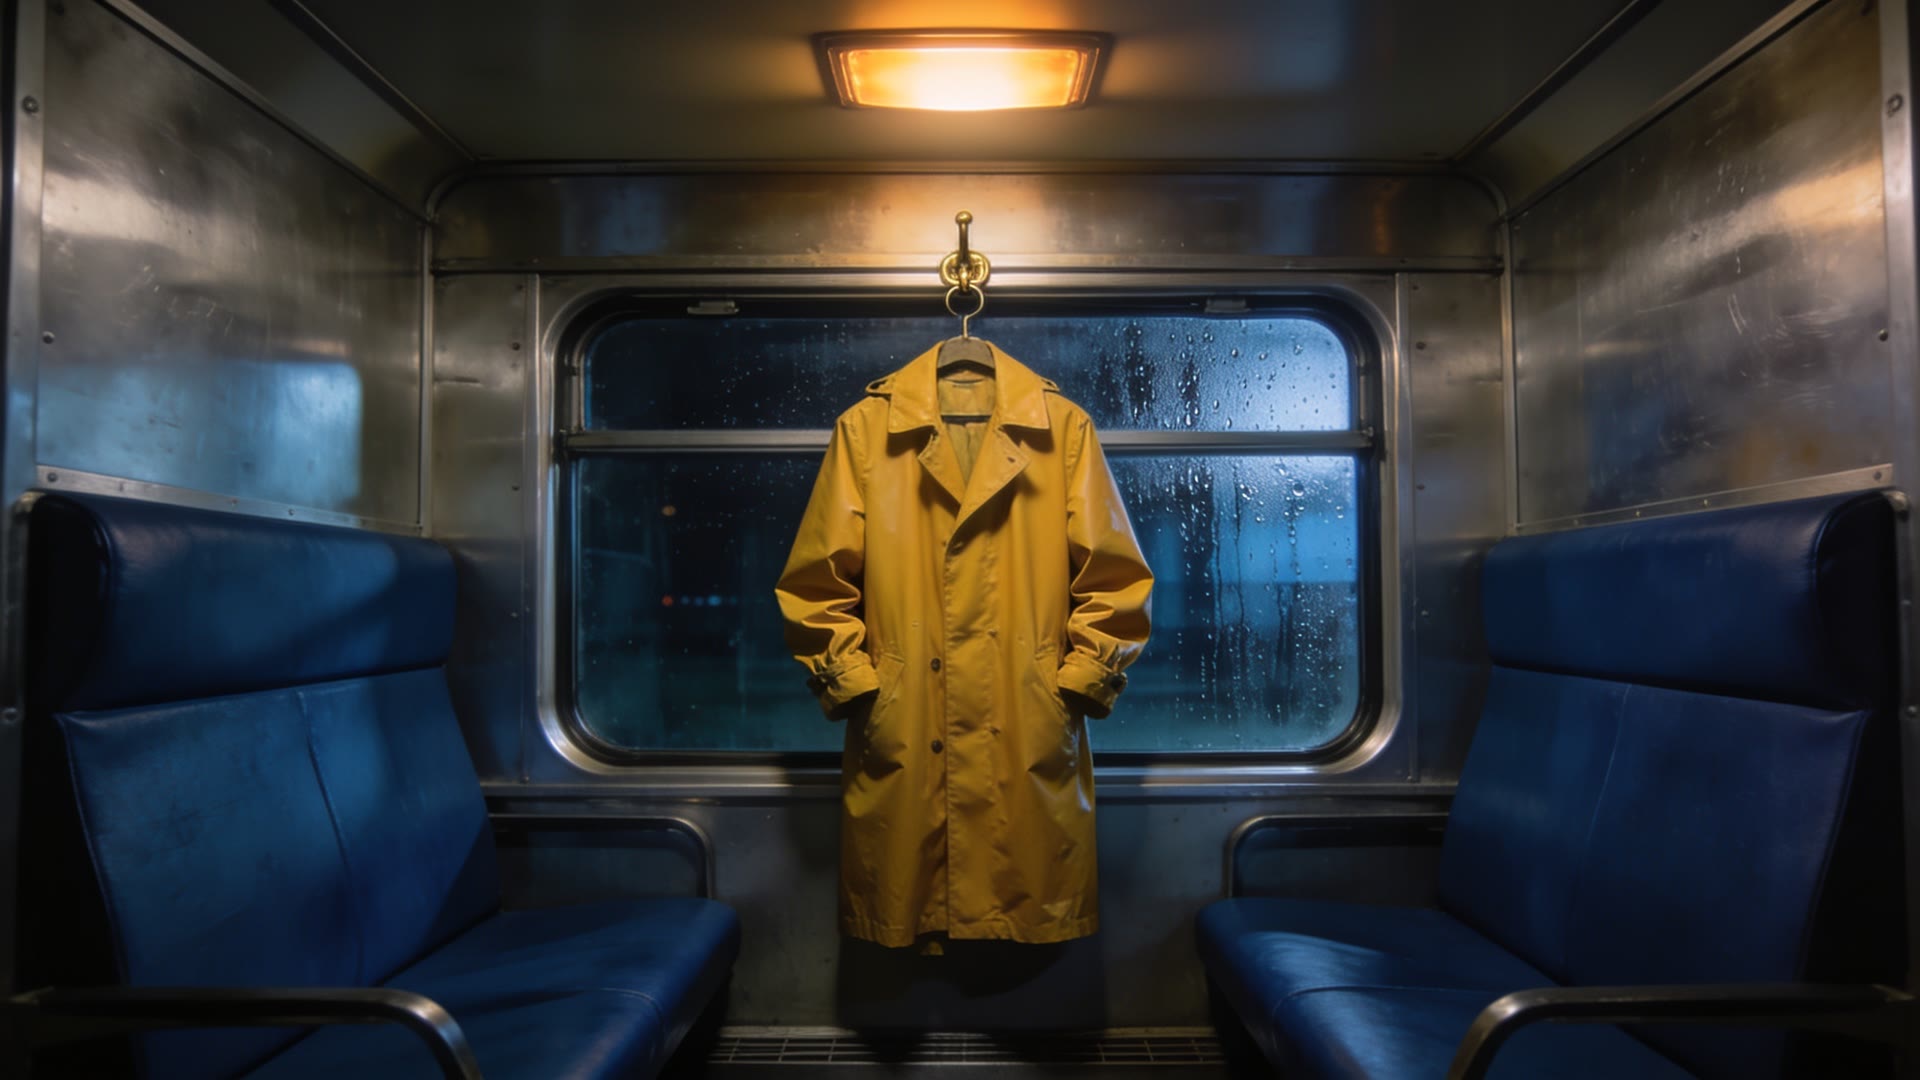
Proviamo un piccolo test di continuità senza volti: un costume, un ambiente e un gesto impossibile. Il protagonista è un impermeabile appeso che si gonfia lentamente, mentre il set resta fermo.
Horizontal 16:9 cinematic production still of a mustard-yellow raincoat hanging alone from a brass hook inside an empty night train compartment, its sleeves subtly inflated as if holding a breath. Brushed steel walls, deep blue upholstery, condensation on the window, one warm practical ceiling light against cool exterior reflections. Shot on a 40mm lens at coat height, strong symmetrical composition, tactile fabric, restrained contrast, no written text, logos, brands, or people.
Slow, controlled dolly toward the hanging raincoat. Its sleeves gradually fill with air, then settle after a tiny release of pressure. Keep the hook, seams, compartment geometry, and lighting unchanged. Subtle train vibration only, no cuts or new objects.
Modello consigliato: GPT Image. Approva prima un frame in cui cuciture, gancio e silhouette siano leggibili. Nel test animato chiedi una sola trasformazione e controlla che il costume non cambi costruzione.
Una domanda pratica — un workflow, quale modello conviene, come verificare un risultato — e la risposta arriva da tutte le edizioni, dai Weekly e dal Manuale, con le fonti e quello che c'è già in FAC. Le risposte sono per il team di Frameworks.
- Come preparo un test in italiano per un personaggio vocale con Eleven Realtime?
- Come confronto Voxtral 3 ed Eleven Realtime su pause, interruzioni e interpretazione?
- Quali controlli faccio dopo Open Eyes e Generative Expand in Lightroom mobile?
- Come organizzo in FAC casting, guardaroba e blocking prima di generare uno spot?
Hai trovato qualcosa che dovremmo leggere?
Un tool, un workflow, un modello, una norma, un artista: mandaci il link e due righe sul perché conta. La redazione legge tutto e il meglio finisce nel notiziario.
📋 Sommario in testo con i link da incollare in chat