← Edizione N° 5 del giovedì 8 ottobre 2026 · In breve
Open d1 decide su immagini e audio, senza generare media
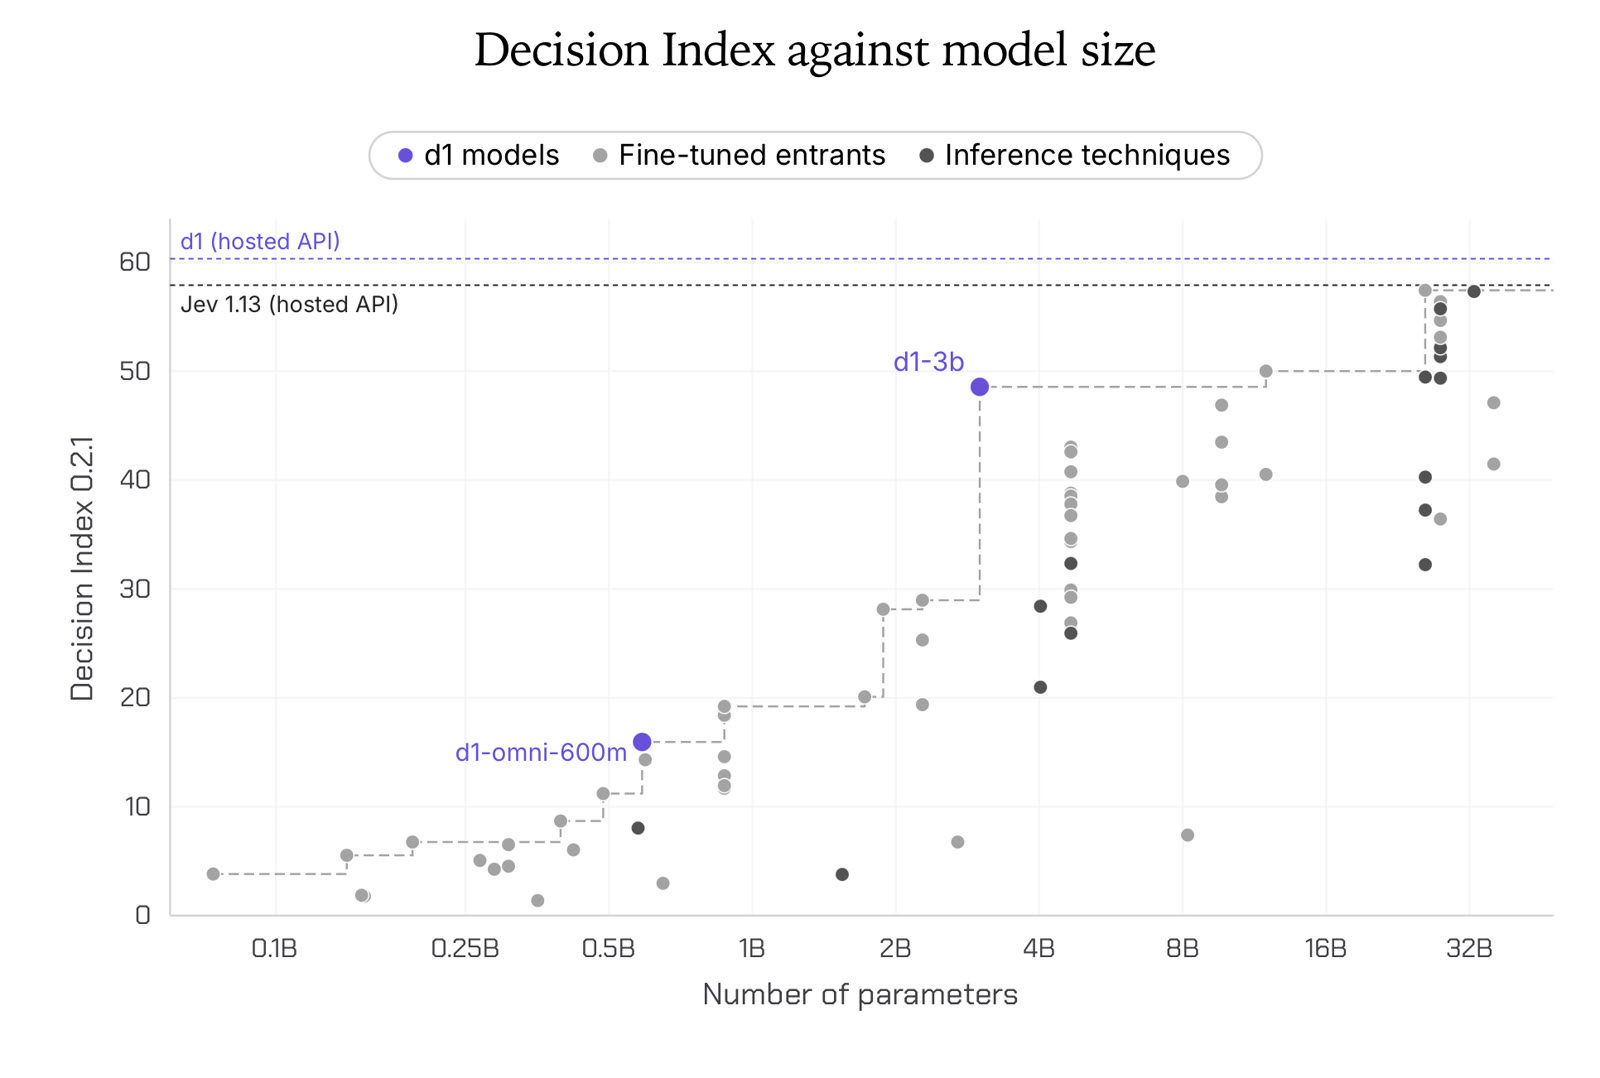
LiquidAI ha pubblicato il 7 ottobre due modelli open-weight per decisioni strutturate: d1-3B accetta testo e immagini; d1-omni-600M, sperimentale, accetta testo con immagini oppure testo con audio. Non generano token in sequenza: restituiscono una decisione attraverso un singolo passaggio del modello. La distinzione conta anche nei test: gli autori non pubblicano benchmark visuali o audio per questa release. La possibile applicazione alla produzione, come nostra ipotesi, è un controllo automatico su asset o reference; non una nuova capacità di creare immagini, voci o clip. ([huggingface.co])
- Pubblicazione
- 7 ottobre
- Distribuzione
- Open-weight
- d1-3B
- Input: testo e immagini
- d1-omni-600M
- Sperimentale; input: testo con immagini oppure testo con audio
- Inferenza
- Decisione attraverso un singolo passaggio del modello
- Multimodal open d1 decision models for the edge Hugging Face
Nella stessa edizione
Una domanda pratica — un workflow, quale modello conviene, come verificare un risultato — e la risposta arriva da tutte le edizioni, dai Weekly e dal Manuale, con le fonti e quello che c'è già in FAC. Le risposte sono per il team di Frameworks.
Hai trovato qualcosa che dovremmo leggere?
Un tool, un workflow, un modello, una norma, un artista: mandaci il link e due righe sul perché conta. La redazione legge tutto e il meglio finisce nel notiziario.