Drama 3 porta la direzione d’attore dentro il TTS
Fish Audio rilascia una voce sintetica guidabile battuta per battuta, anche su singole parole. L’editing delle take resta però in accesso limitato: generare una performance e correggerla sono ancora due passaggi distinti.
Drama 3: dirigere la battuta, non soltanto scegliere la voce
Fish Audio ha annunciato Drama 3 il 13 ottobre: il modello text-to-speech è disponibile sul sito, nelle app e via API. La novità da guardare è il controllo della recitazione: indicazioni in linguaggio naturale accompagnano il copione e possono cambiare l’interpretazione durante una frase. Per chi prepara dialoghi, animatic o voiceover, il punto non è aggiungere emozione indistinta, ma collocarla dove serve alla scena. ([beta.fish.audio])
Le istruzioni entrano tra parentesi quadre prima del passaggio interessato: intenzione, ritmo, destinatario della battuta. Respiri, risate e pause si inseriscono nel punto in cui devono avvenire; tag accoppiati circoscrivono invece un sussurro o un’enfasi a parole precise. La documentazione permette inoltre di scrivere la direzione in una lingua diversa dal dialogo. Attenzione all’integrazione: se l’header del modello manca o contiene un errore, l’API torna a S2.1 Pro senza far fallire la richiesta. ([docs.fish.audio])
Sotto c’è un’architettura mixture-of-experts da 35 miliardi di parametri, con circa 3 miliardi attivi per token. I pesi sono scaricabili; il modello supporta 83 lingue e la generazione multi-speaker. Sono caratteristiche utili per sperimentare scene e versioni linguistiche, non una verifica della qualità sul nostro materiale. Il test da fare resta quindi sul copione reale: pronuncia, tenuta della voce e aderenza alle indicazioni vanno ascoltate separatamente, senza promuovere una take solo perché espressiva. ([huggingface.co])
Il confine operativo più importante riguarda le correzioni. Fish mostra editing interattivo e audio inpainting, ma li dichiara ancora in piccoli test su invito, con un’API di editing in arrivo. Non vanno quindi presentati come strumenti già disponibili a tutti. Anche “pesi aperti” richiede precisione: la Community License prevede condizioni commerciali legate al fatturato e una licenza separata per offrire il modello come servizio. Non è un rilascio open-source senza restrizioni. ([beta.fish.audio])
Per una prima prova proponiamo una scena breve, con una sola voce e un cambio d’intenzione leggibile: una rassicurazione che diventa esitazione. Tenete identico il testo e cambiate soltanto la direzione, poi ascoltate le take senza guardare quale prompt le ha generate. Annotate dove cade la pausa e quale parola riceve l’accento. Solo dopo passate al dialogo fra personaggi. È un modo concreto per capire se il controllo serve davvero al montaggio, prima di costruire un workflow attorno alle funzioni di editing ancora riservate.
- Disponibilità
- Sito, app e API; pesi scaricabili
- Lingue
- 83
- Parametri
- 35 miliardi totali; circa 3 miliardi attivi per token
- Editing
- Piccoli test su invito; API in arrivo
- Licenza
- Community License con condizioni commerciali legate al fatturato; licenza separata per offrire il modello come servizio
- Fish Audio Releases Drama 3, a 35B Open-Weight MoE Text-to-Speech Model MarkTechPost
- Fish Audio Drama 3: The Most Emotive Text-to-Speech Model We've Built Fish Audio
- Drama 3 Fish Audio
- fishaudio/drama-3 — Model card Fish Audio · Hugging Face
In breve tutte le notizie →
Kling arriva nelle API Runway, anche con prompt multishot
Il changelog Runway Dev del 13 ottobre aggiunge Kling. Per Kling 3.0 sono documentate le varianti Standard, Pro e 4K, con generazioni da 3 a 15 secondi, primo e ultimo frame e audio opzionale, attivo per impostazione predefinita. I prompt multishot possono contenere fino a sei segmenti, sempre entro la durata complessiva prevista. È una nuova via di accesso al modello, non una nuova versione di Kling: parametri, risoluzioni e tariffe descritti appartengono all’integrazione Runway Dev e non dimostrano che gli stessi controlli siano già esposti in FAC. ([docs.dev.runwayml.com])
Gen-4.5 e Aleph 2.0 possono girare su infrastruttura dedicata
Baseten ha annunciato il 14 ottobre un accordo con Runway per distribuire Gen-4.5 e Aleph 2.0 in ambienti single-tenant. L’azienda cliente ottiene la licenza dei pesi direttamente da Runway e li esegue su risorse GPU dedicate gestite da Baseten. L’offerta comprende anche versioni fine-tuned e capacità riservata. Il fatto nuovo è quindi il modo di distribuire i modelli, non un miglioramento dichiarato della generazione: per uno studio può diventare una strada da valutare quando isolamento dei carichi e personalizzazione contano più della semplicità di un servizio condiviso. ([baseten.co])
Plugin Adobe: CEP resta operativo mentre avanza UXP
Nel riepilogo Developers Live pubblicato il 14 ottobre, Adobe ribadisce che i plugin CEP continueranno a funzionare fino al 2029, mentre UXP diventa la piattaforma di riferimento. Lo stesso aggiornamento descrive il passaggio dagli assistenti AI alle lavorazioni delegate e anticipa altre notizie su Firefly Graph a MAX. Non è il lancio di un nuovo modello Firefly. Per la post-produzione, la parte concreta è la continuità dichiarata dei plugin esistenti: la migrazione va pianificata, senza leggere questo riepilogo come un invito a sostituire subito i pannelli della pipeline. ([blog.developer.adobe.com])
La stanza trattiene il respiro
Proviamo a suggerire una performance senza mostrare chi parla. Una cabina di registrazione vuota, con un solo indizio di presenza, diventa un esercizio di regia: la tensione deve stare nella luce e nel tempo, non in un’espressione facciale.
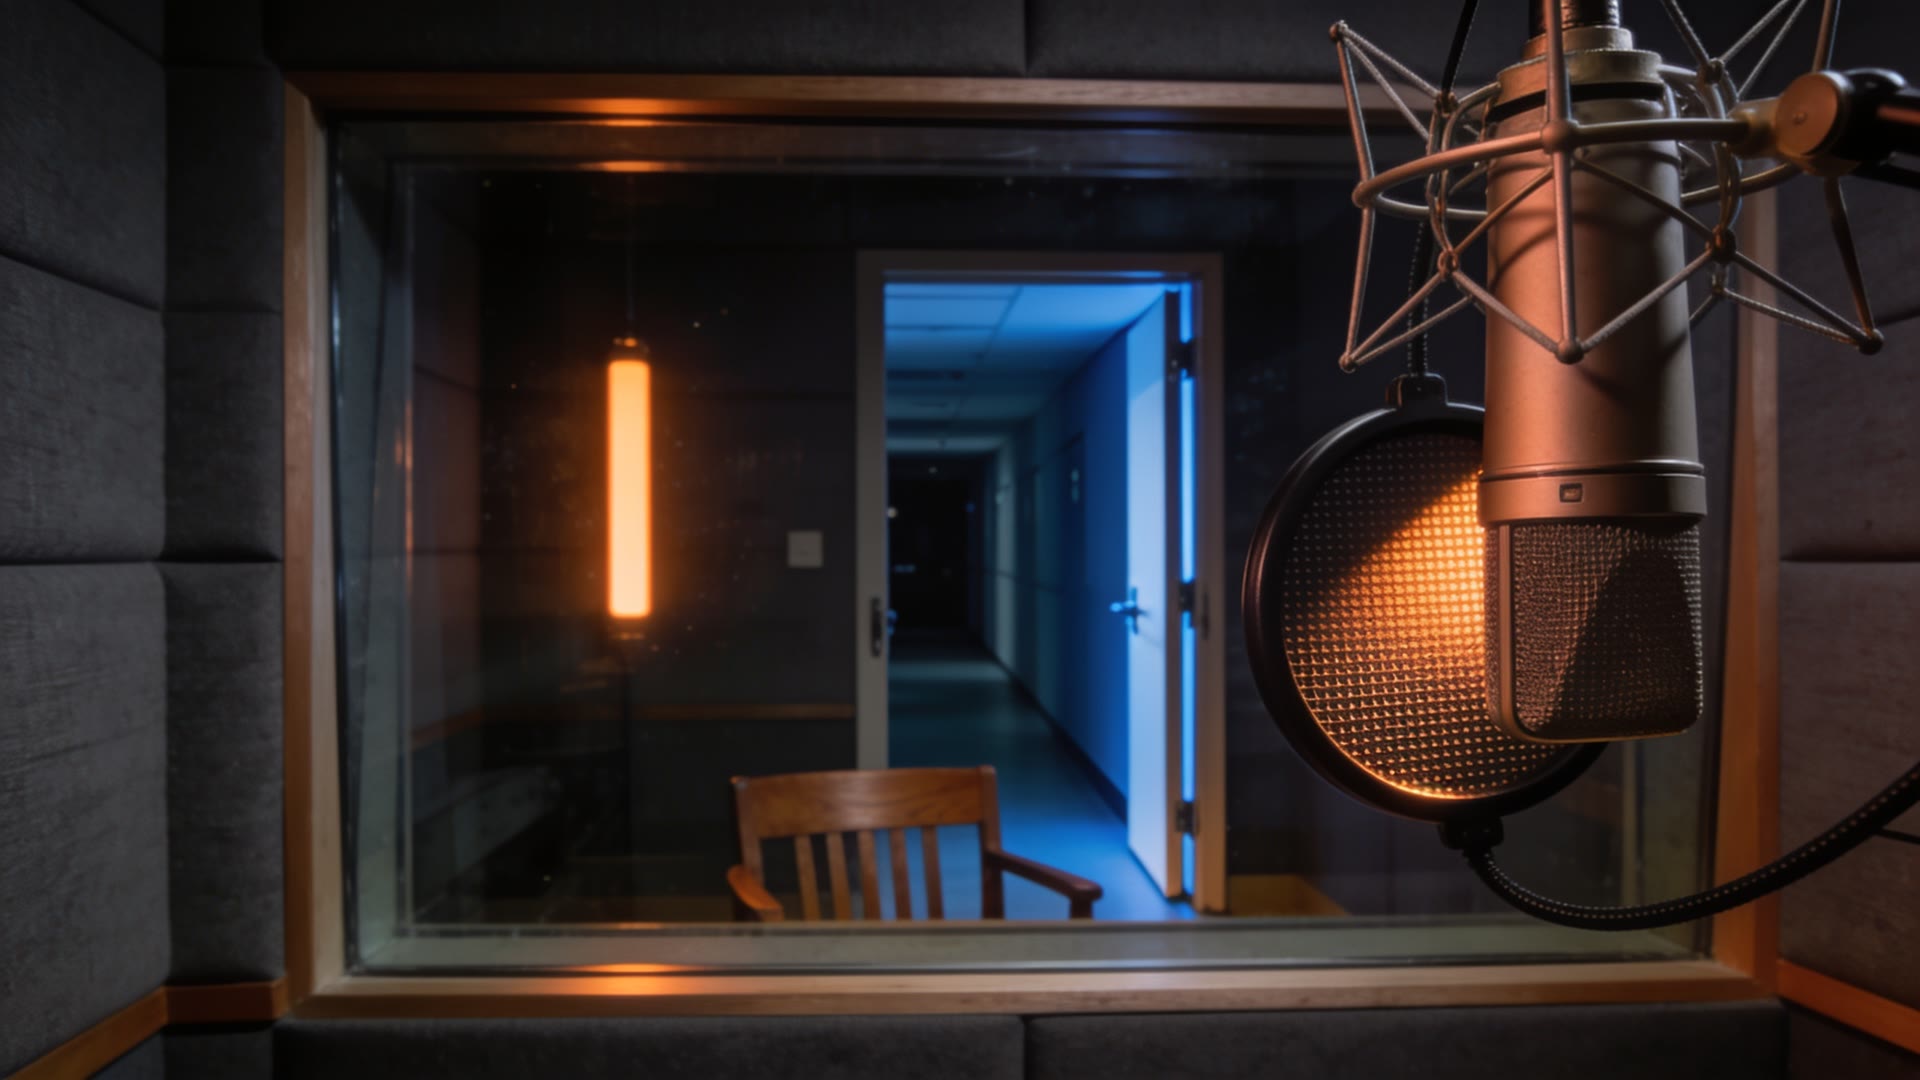
Cinematic widescreen 16:9 frame of an empty recording booth at night, a suspended vintage microphone in the foreground and one unoccupied wooden chair beyond the glass. A narrow amber practical light grazes the microphone grille; cold blue corridor light cuts through a half-open door. Shot on a 50mm lens, shallow depth of field, restrained film grain, charcoal and muted copper palette, strong negative space, tactile acoustic fabric, no lettering, no logos.
Slow dolly toward the suspended microphone. Its cable sways almost imperceptibly, then settles. Beyond the glass, the half-open door moves a few centimeters and stops. Keep the chair empty, preserve the lighting, and hold one continuous shot without cuts.
Modello consigliato: Seedream. Fate prima una versione a camera fissa: se la tensione non regge, correggete luce e durata prima di aggiungere il dolly. Tenete il movimento del cavo separato da quello della porta nelle indicazioni.
Una domanda pratica — un workflow, quale modello conviene, come verificare un risultato — e la risposta arriva da tutte le edizioni, dai Weekly e dal Manuale, con le fonti e quello che c'è già in FAC. Le risposte sono per il team di Frameworks.
- Come possiamo confrontare due direzioni di Drama 3 mantenendo identico il copione?
- Quali controlli multishot e audio di Kling sono effettivamente esposti in FAC?
- Quando avrebbe senso valutare infrastruttura dedicata per i modelli Runway?
- Come censiamo i pannelli CEP indispensabili e pianifichiamo la migrazione a UXP?
Hai trovato qualcosa che dovremmo leggere?
Un tool, un workflow, un modello, una norma, un artista: mandaci il link e due righe sul perché conta. La redazione legge tutto e il meglio finisce nel notiziario.
📋 Sommario in testo con i link da incollare in chat