📰 Le notizie
apertura e brevi di ogni edizione: modelli, strumenti, ricerca, industria e regole della produzione generativa 1 nov 2026 · non in FACVideo · PikaPika apre i pesi di H3 Flex, il MiniMax H3 pensato per iterare
Sei passi di denoising invece di cinquanta: secondo Pika, 15 secondi a 768p in sette secondi di calcolo.
 1 nov 2026 · non in FACAudio · ElevenLabsElevenLabs mette più suoni in un solo prompt con SFX v3
Più suoni in ordine con un solo prompt.
 31 ott 2026Regole · Sag-aftraSAG-AFTRA chiude i contratti dell'animazione tv con più tutele sull'AI
Ratificati due contratti di animazione tv fra SAG-AFTRA e AMPTP.
 30 ott 2026 · non in FACAudio · AssemblyaiAssemblyAI entra nella sintesi vocale a 15 dollari per milione di caratteri
Primo modello TTS di AssemblyAI, pensato per i voice agent.
 29 ott 2026 · non in FACAudio · NVIDIANvidia pubblica un modello gratuito che trascrive 40 lingue
Gratuito e aperto, fino a 40 lingue.
 28 ott 2026 · non in FACWorld Model · GoogleGenie 4 genera mondi esplorabili, con suono e personaggi che parlano
Scena coerente fino a due minuti, il doppio di Genie 3.
 27 ott 2026 · non in FACAudio · TecnicaPrima della voce, controlliamo come il testo verrà letto
La guida è nuova; non annuncia una nuova versione del motore.
 23 ott 2026 · non in FACAudio · GradiumPhonon porta il TTS sul dispositivo, con licenze da distinguere
Phonon 31m inglese è disponibile con licenza Apache 2.0.
 22 ott 2026 · non in FACAudio · ElevenLabsElevenLabs porta la traduzione vocale dentro la conversazione
Accesso alpha riservato ai clienti enterprise.
 21 ott 2026 · non in FACAudio · ElevenLabsEleven Realtime porta il personaggio dentro la conversazione
Due modelli speech-to-speech: Mini per conversazioni, Max per compiti complessi.
 21 ott 2026 · non in FACAudio · MistralVoxtral 3 separa ascolto, ragionamento e voce
SDK e modelli distinti collegano ascolto, ragionamento e voce.
 20 ott 2026 · api in arrivoVideo · KlingKling 4.0: il prossimo test passa da dialoghi e spazio sonoro
Il rilascio porta stereo e lip-sync multilingue; non equivale alla disponibilità API.
 19 ott 2026 · non in FACAudio · WorkflowUna scena radiofonica mostra perché il formato del prompt conta
Separare dialogo e indicazioni è parte della preparazione.
 19 ott 2026 · non in FACVoce · TestLo stesso copione produce durate diverse: il TTS va ascoltato sul cut
Testo identico non significa durata identica.
 18 ott 2026 · non in FACAudio · IndustriaElevenLabs aggiorna la documentazione sulle verifiche di sicurezza
ElevenLabs annuncia il rinnovo delle verifiche su sicurezza, privacy e gestione dell’AI.
 17 ott 2026 · non in FACFormazione · AdobeFirefly: una sessione dedicata al percorso video e audio
Adobe ha programmato per il 15 ottobre una sessione formativa sui workflow video generativi in Creative Cloud.
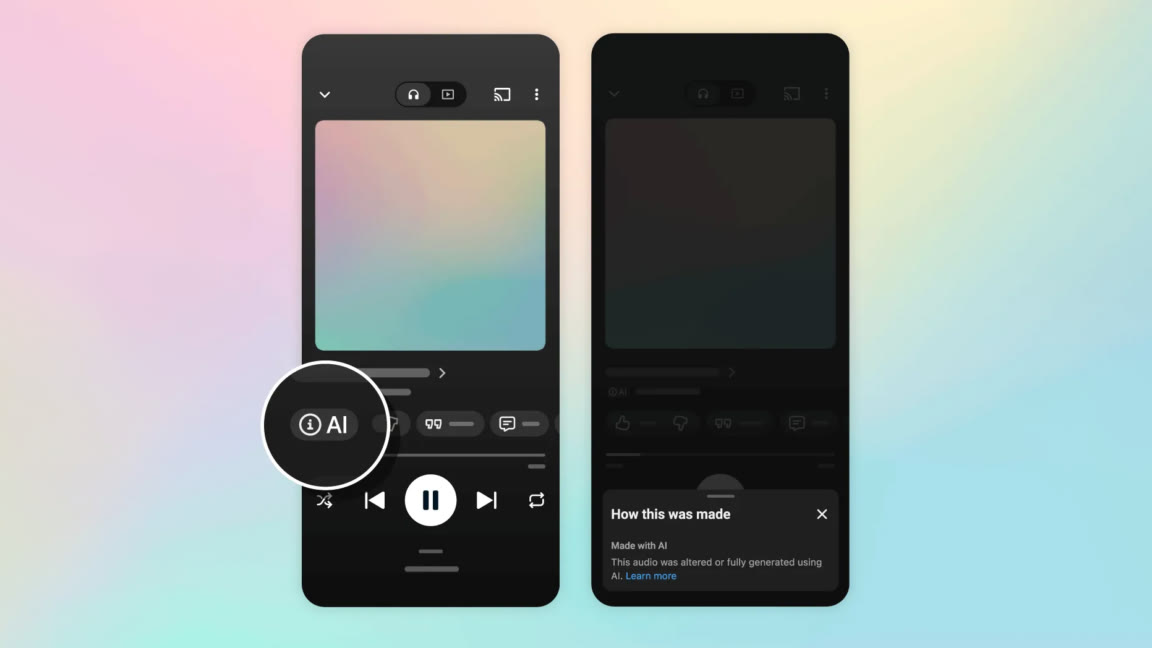 16 ott 2026Audio · EtichetteYouTube Music comincia a indicare i brani generati con AI
YouTube Music introduce un’etichetta per brani interamente generati o modificati significativamente con AI; seguiranno i video musicali.
 15 ott 2026 · non in FACAudio · FishDrama 3: dirigere la battuta, non soltanto scegliere la voce
Drama 3 permette di dirigere intenzione, ritmo, pause ed enfasi anche durante una frase.
 14 ott 2026 · non in FACAudio · ElevenLabsInterviste: trascrizione integrale prima del testo ripulito
Scribe v2 distingue trascrizione verbatim, predefinita, e clean, selezionabile nel Playground o tramite API.
 13 ott 2026Produzione · CostiIl costo utile è quello della clip che passa la review
Alex Wang descrive quattordici clip generate, delle quali sette considerate pubblicabili.
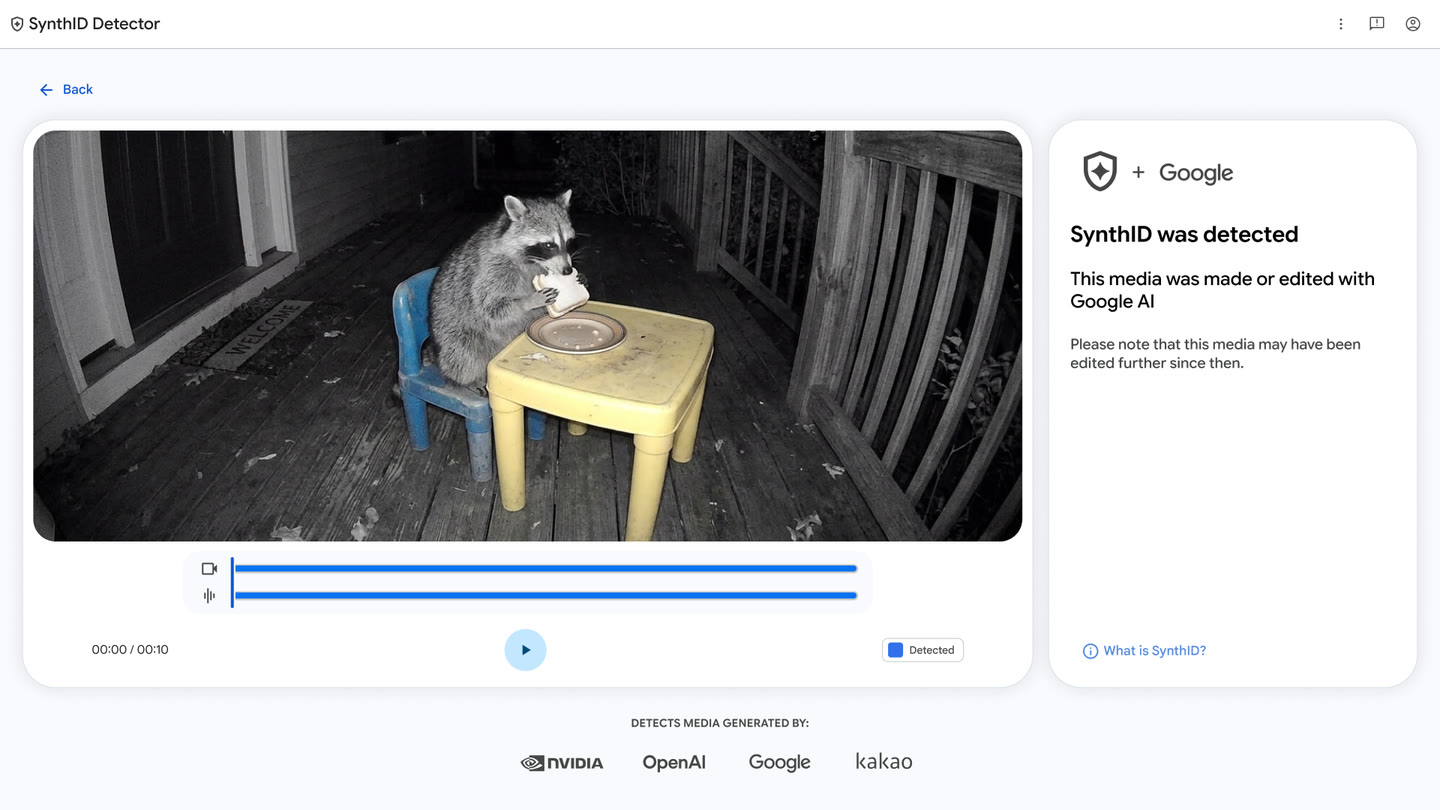 9 ott 2026Verifica · GoogleSynthID Detector apre al pubblico: cerca watermark, non autenticità
SynthID Detector apre globalmente e cerca watermark compatibili in immagini, video e audio.
 8 ott 2026 · non in FACStrumenti · GooglePlayground: dal concept visivo a un’esperienza che si può giocare
Playground crea esperienze giocabili da prompt nel browser, senza scrivere codice.
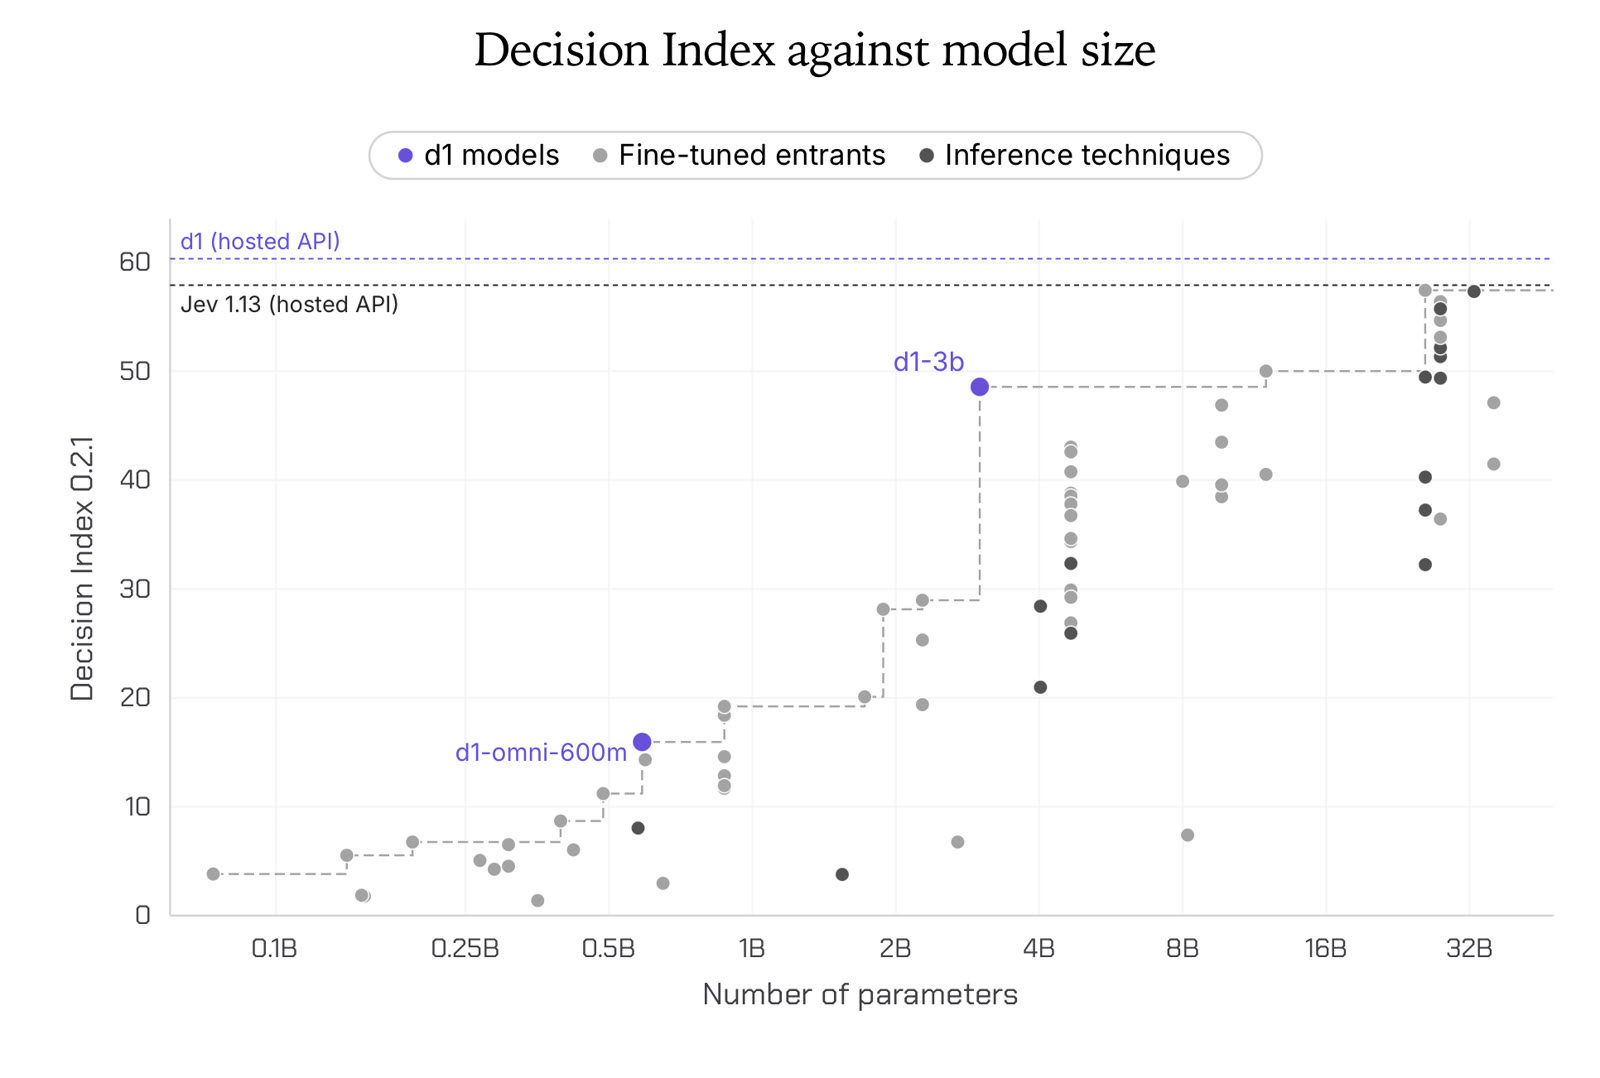 8 ott 2026 · non in FACRicerca · LiquidaiOpen d1 decide su immagini e audio, senza generare media
LiquidAI pubblica due modelli open-weight per decisioni strutturate, non per generare media.
 7 ott 2026 · non in FACAudio · ElevenLabsUna guida per cercare parole, risate e applausi nel girato
La guida ElevenLabs descrive un workflow di trascrizione, non il rilascio di un nuovo modello.